2026-03-18 / AGENTIC DATA STACK
Agentic Data Stack 评估框架:定义 Agent-ready 系统的六项原则
从 CLI/MCP 接口、渐进式知识获取、版本与回滚、轻量与弹性、双模式执行,以及稳定性六个方面评估数据平台。
为什么传统指标不足以评估 Agent
传统数据平台关注查询速度、存储成本、连接器数量和界面体验。这些指标服务于人类用户,却不能说明系统是否适合 Agent。
Agent 需要解析结构化数据、读取机器可读的契约,并通过结构化错误码处理异常。一个传统指标达到 95 分的平台,如果错误信息不结构化、操作不幂等、指标定义没有版本,Agent 依然可能需要人反复介入。
评估重心应从接入能力转向任务结果:不仅是 Agent 能否访问工具,更要看它能否把目标变成可投入生产的成果,持续自主执行。
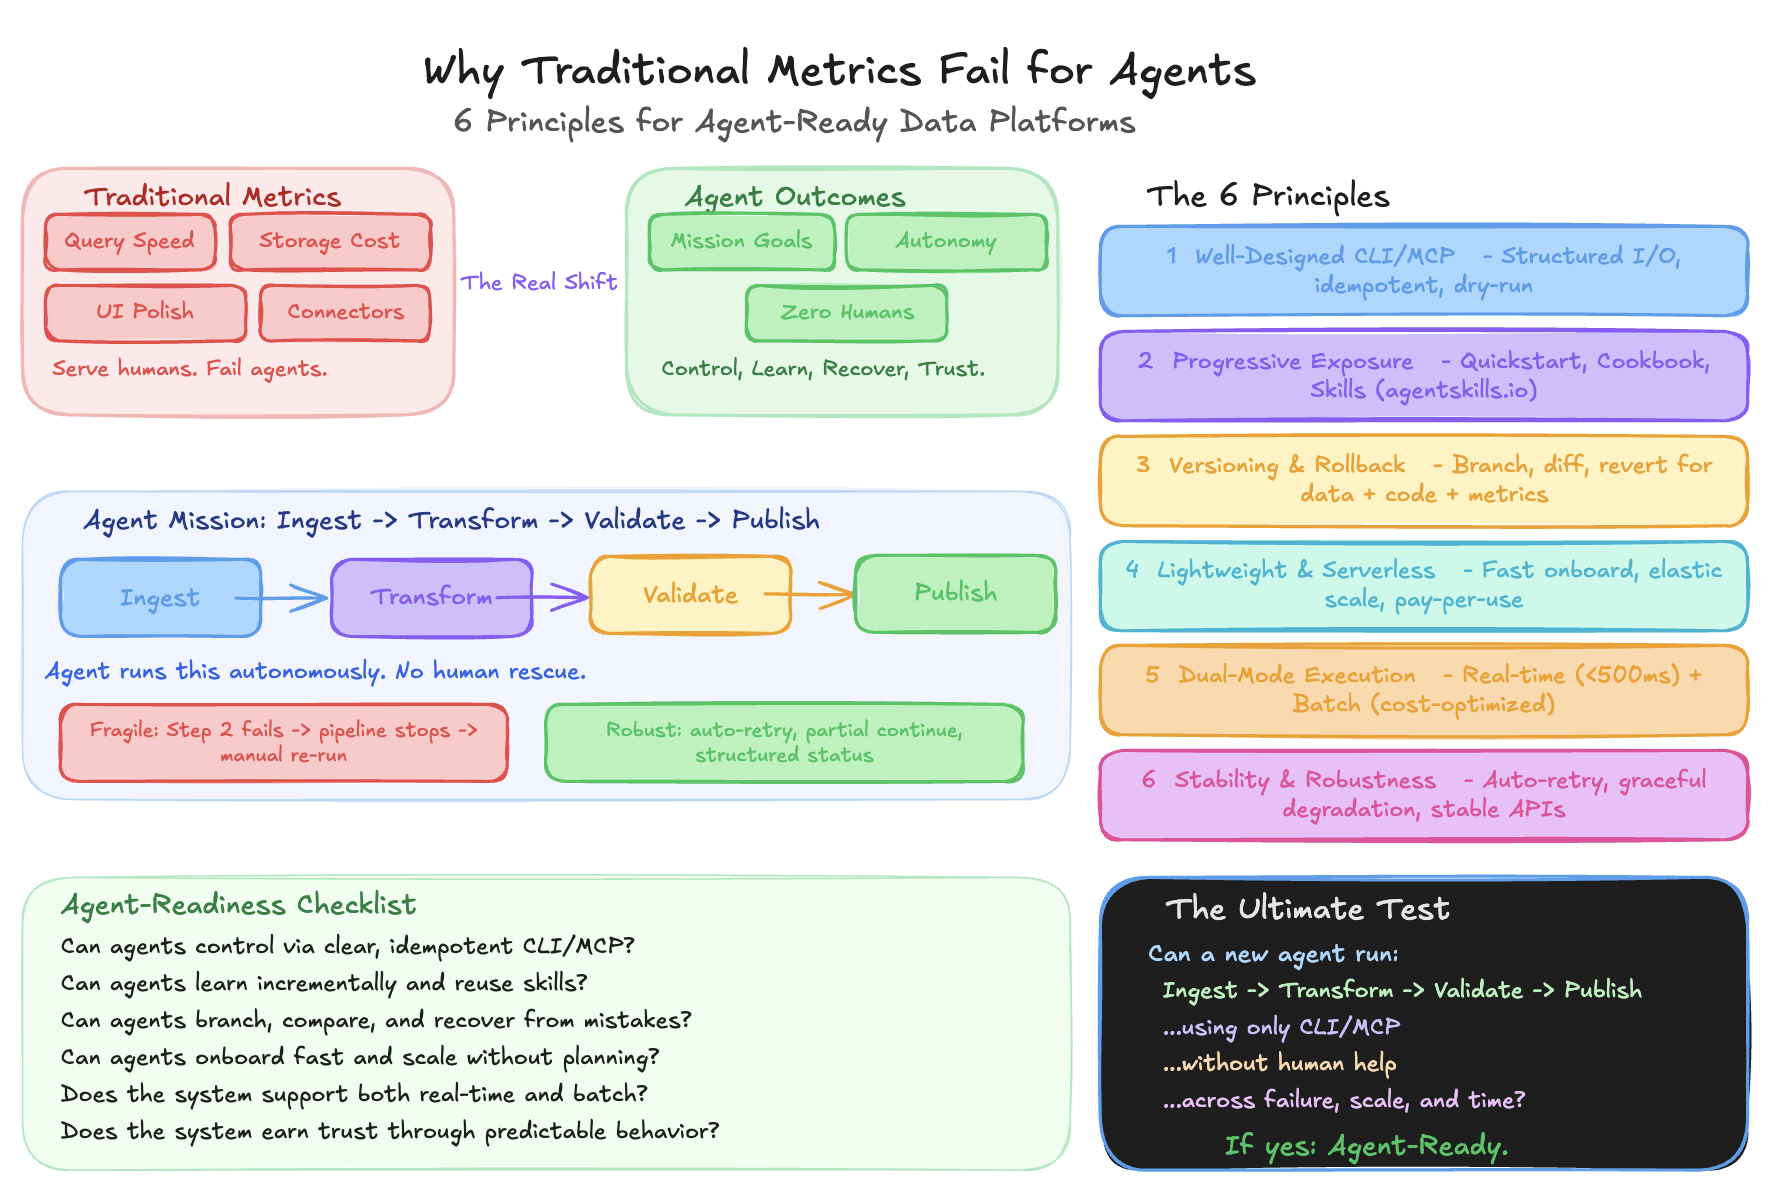
原则一:设计良好的 CLI/MCP
CLI 和 MCP 服务是 Agent 的主要操作接口,应作为一等契约设计。
- 精简参数:避免让 Agent 在几十个标志中猜测。
- 结构化输入输出:使用 JSON/YAML,而非散文式消息或 HTML 错误页。
- 可执行的错误码:提供恢复建议,而非只提示联系支持。
- 幂等操作:重复调用得到相同结果。
- Dry-run 模式:执行前预览影响。
- 完整覆盖:界面能完成的操作,也能通过 CLI/MCP 完成。
反例是各工具采用不同认证方式、返回 HTML 错误,迫使 Agent 解析日志。更好的方式是统一认证、带修复建议的 JSON 错误、危险操作的 --dry-run 和可解析的状态查询。
具有类型化参数、结构化响应和清晰错误的完整 MCP 服务,可以降低不同 Agent 框架的集成成本。
检验方法:新 Agent 能否仅靠 CLI/MCP,在无人帮助下完成数据接入、转换、验证和发布?
原则二:渐进式暴露知识——Skills 与文档
文档与 Skills 让经验可被复用。关键是按需、分层提供知识,而不是一次塞入数百页文档,或完全不提供文档。
- 快速开始:用十行脚本获得首次成功。
- 操作手册:覆盖从 S3 加载、处理 Schema 漂移、超时重试等任务。
- 参考规范:提供完整接口、错误码和限制。
- 故障排查:将错误码连接到原因和可执行的恢复方法。
Agent Skills 将重复工作转化为具有清晰边界、经过测试的持久能力。临时提示词会消失,Skill 可以持续复用。例如,将空值、重复与 Schema 检查封装成统一调用:
data-quality-check --table orders --checks null,duplicate,schema --threshold 95
这样可以统一调用方式、比较评分,并组合到流水线中。
检验方法:文档覆盖的任务首次成功率超过 80%;重复任务被沉淀为可复用 Skill。这里的数值为本文提出的评估目标。
原则三:版本管理与回滚
LLM 的概率性决定了它无法保证零错误。关键是出错后能否安全恢复。
- 数据:检查点、时间旅行和表快照。
- 代码:通过 Git 管理流水线逻辑。
- 指标:跟踪定义变化。
- 环境:保存依赖版本和配置快照。
- ETL 任务:保证可重入,重复执行不产生重复数据。
data-stack branch create "add_customer_ltv_metric"
data-stack run pipeline --dry-run
data-stack validate --compare-to main
data-stack commit "Added LTV metric with 30-day window"
data-stack diff main..add_customer_ltv_metric
data-stack merge add_customer_ltv_metric --into main
data-stack revert --to-commit abc123
如果 Agent 把收入从 SUM(order_total) 改成 SUM(order_total) - SUM(refunds),却没有版本记录,历史报表就会悄然变化。版本机制让 Agent 能比较差异、解释数字变化、验证新定义并回滚错误。
检验方法:关键数据、代码和指标中,具备版本及完整血缘的比例。
原则四:轻量客户端与 Serverless 弹性
轻量客户端决定接入难度,弹性扩展决定后续规模。
如果首次查询前就需要 2GB 运行时、15 个环境变量及专用计算资源,许多工作流将难以启动。理想系统应减少依赖,在几分钟内获得首次成功。
数百个 Agent 并行执行时,还需要自动扩容、按使用付费和避免执行争用。作为说明性对比:简单聚合若需启动 Spark 集群并等待五分钟,负担明显高于通过轻量客户端调用两秒内响应的 Serverless 端点。具体成本和并发能力须以实际系统测量为准。
检验方法:从零到首次操作所需时间,以及 10 倍、100 倍并发下的成本。
原则五:低延迟与成本优化双模式
面向用户的交互要求低延迟;批处理更重视成本。两者应被分别支持。
| 维度 | 低延迟模式 | 成本优化模式 |
|---|---|---|
| 场景 | 实时查询、仪表盘 | 批量 ETL、回填、训练 |
| 延迟目标 | 小于 500ms | 分钟至小时 |
| 计算方式 | 热缓存、预留资源 | 竞价资源、排队执行 |
| 成本特点 | 单次查询成本较高 | 单条记录成本较低 |
只支持昂贵实时计算或缓慢批处理,会遗漏一部分场景。最好通过单个参数切换模式,无需修改业务代码。
检验方法:交互查询 P95 延迟、批处理单记录成本,以及模式切换是否需要修改代码。
原则六:稳定性与鲁棒性
当代码生成成本下降,信任变得更有价值。稳定的接口和可预测的行为,往往比极致性能更重要。
Agent 需要向后兼容、负载下的优雅降级和透明的失败模式。系统应通过超时重试、限流退避、故障切换和部分失败隔离,减少 Agent 对基础设施的照看。
脆弱流程会因第二步临时过载而全部中断;稳健流程会自动退避重试,让独立步骤继续,并返回“已完成 80%,第二步正在重试”等结构化状态。
CLI 参数和 MCP Schema 应像公开 API 一样维护版本、文档和弃用路径,避免小版本升级破坏已有工作流。
检验方法:故障下的任务完成率、自动恢复率,以及每年的破坏性接口变更次数,目标为零。
六项原则检查表
| 原则 | 核心问题 |
|---|---|
| CLI/MCP | Agent 能否通过清晰、完整、幂等的接口控制系统? |
| 渐进式知识获取 | 能否逐步学习并复用最佳实践? |
| 版本与回滚 | 能否创建分支、比较并从错误中恢复? |
| 轻量与 Serverless | 能否快速接入并自动扩展? |
| 双模式执行 | 是否同时支持实时与批处理? |
| 稳定与鲁棒 | 系统是否通过可预测的行为建立信任? |
Agent-readiness 的关键是 Agent 能否控制、学习、恢复、扩展、优化并信任系统,将意图转化为生产成果。