2026-03-22 / AGENTIC DATA STACK
Agentic Data Stack 评估 FAQ:数据平台团队的实践问答
从量化 Agent-readiness,到改进现有工具的接口、恢复能力与版本机制,回答平台团队的常见问题。
如何评估 Agent-ready 数据技术栈
Modern Data Stack 与 Agentic Data Stack 有什么不同?
Modern Data Stack 一词经 a16z 的 2020 年报告广泛传播,描述模块化、云原生、以 SQL 为中心的工具体系,包括云数仓、ELT、BI 和反向 ETL,主要服务人类分析师与数据工程师。
Agentic Data Stack 在此基础上,将主要操作者扩展为有人监督的 AI Agent。a16z 关于 AI 与数据工程的讨论也涉及从人工操作界面向 Agent 编排流水线的转变。
架构对比
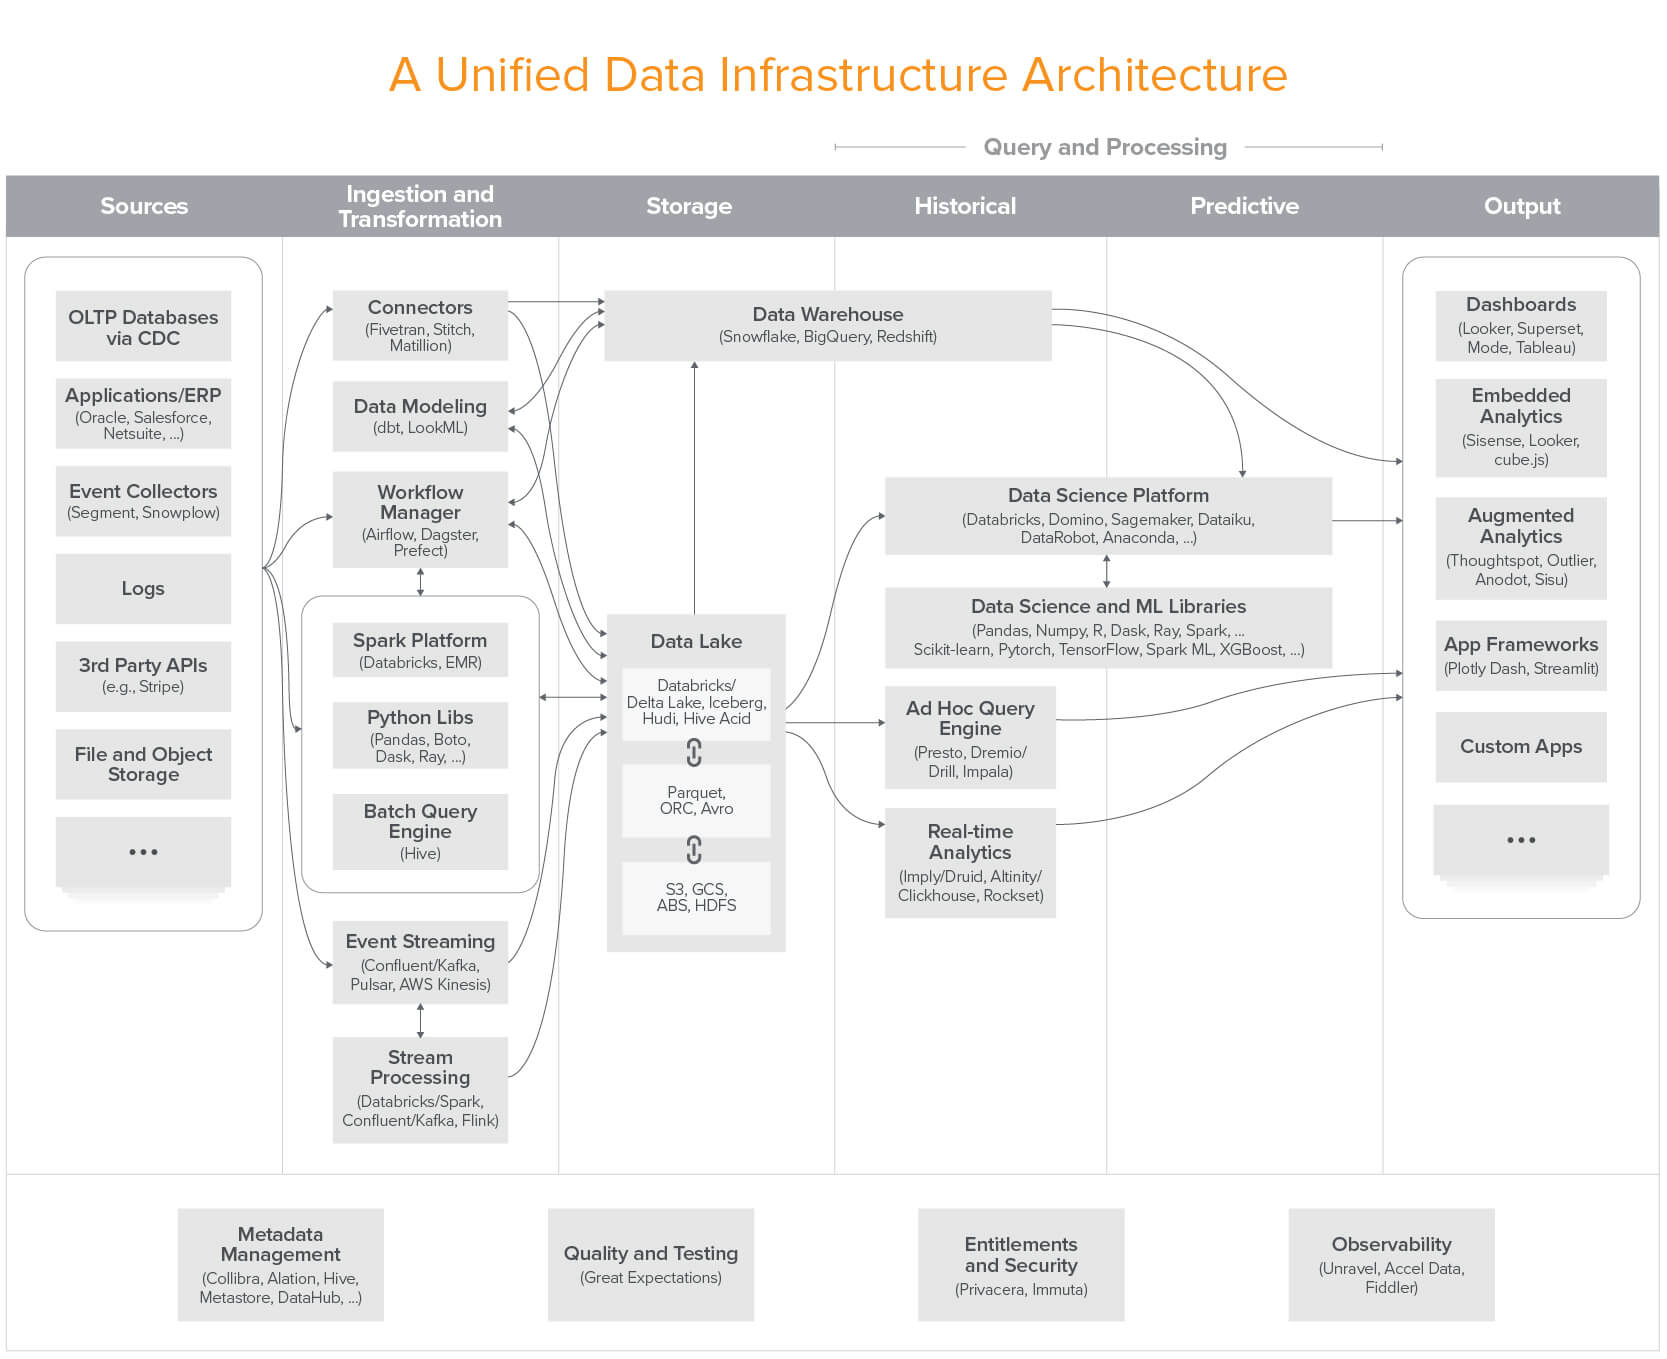
来源:a16z — Emerging Architectures for Modern Data Infrastructure。
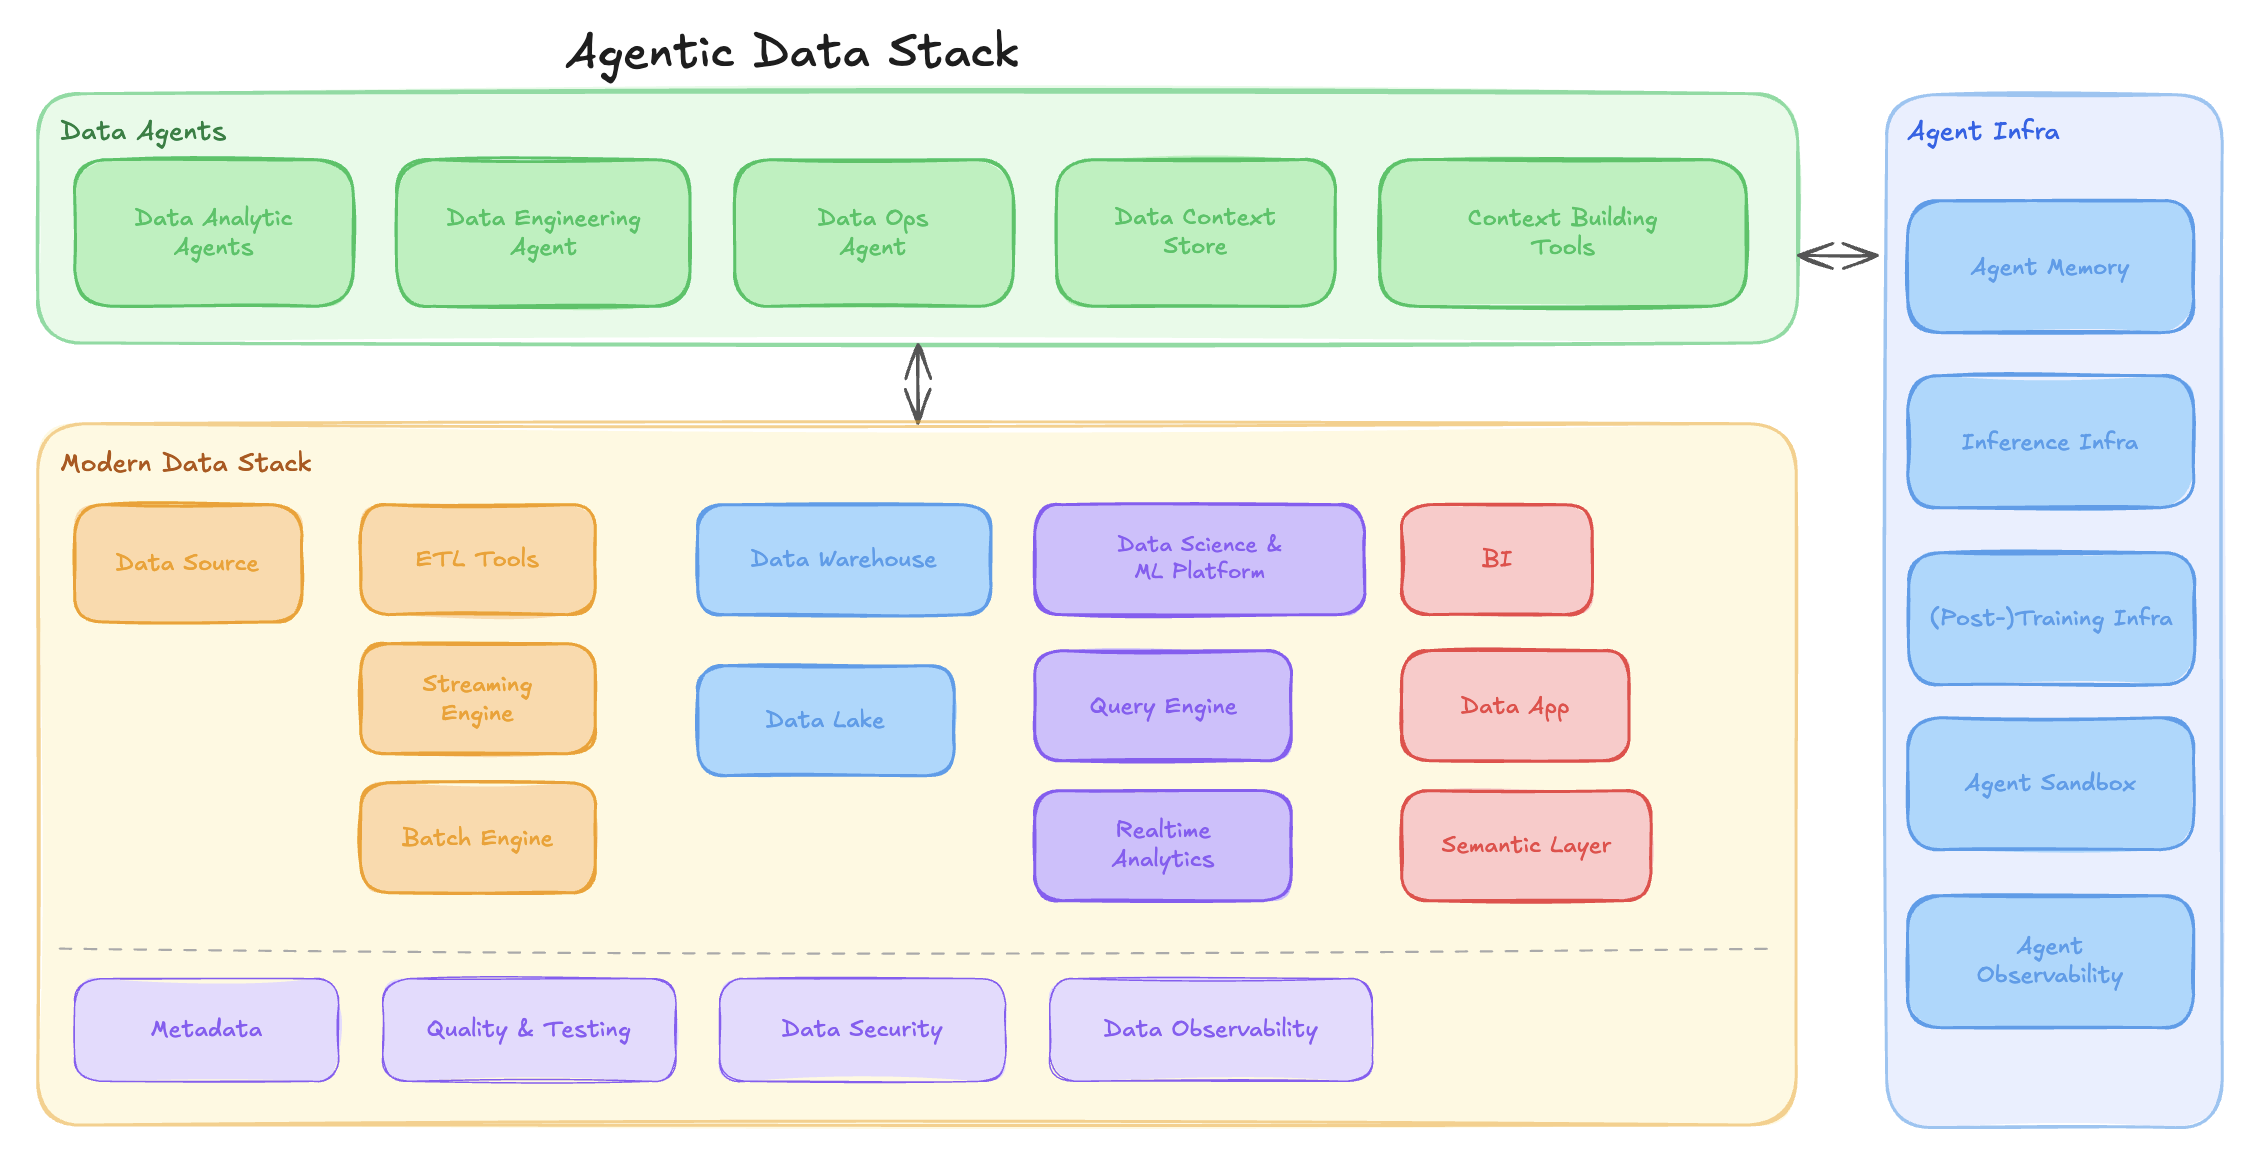
Modern Data Stack 构成基础层,新增 Data Agent 与配套的记忆、沙箱和可观测性基础设施。
| 维度 | Modern Data Stack | Agentic Data Stack |
|---|---|---|
| 主要操作者 | 分析师与工程师 | 由人监督的 AI Agent |
| 接口 | 仪表盘、SQL 编辑器、拖拽操作 | CLI、MCP、结构化 API |
| 错误处理 | 面向人的提示与日志 | 结构化错误码与恢复建议 |
| 迭代方式 | 人工编辑、执行、检查 | 基于版本状态自主重试 |
| 知识 | 文档、Wiki、隐性经验 | Skills、机器可读规范 |
| 编排 | 定时 DAG | 目标驱动、自适应任务 |
Modern Data Stack 提供构件,Agentic Data Stack 让机器能够可靠地操作这些构件。社区定义见关于页面。
有 CLI/API 就算 Agent-ready 吗?
不算。CLI 是接入基础,不是完成任务的证明。真正需要检验的是 Agent 能否通过它控制、学习、调试、恢复、管理版本和改进系统。
许多 SQL 引擎和 ETL 工具已有 API,却返回非结构化错误、缺少幂等性或 Dry-run,因此仍难以被 Agent 稳定使用。
如何量化 Agent-readiness?
本文建议在 20 次任务中观察以下指标,数值为评估目标,而非行业统一标准:
- 任务完成率:超过 85%。
- 每项任务人工介入次数:少于两次。
- 失败自动恢复率:超过 70%。
- 单任务成本趋势:第 20 次相比首次降低 50%。
- 新 Agent 首次成功所需时间:少于一天。
- Skill 复用率:超过 60% 的任务使用已有 Skill。
为什么系统对人可靠,Agent 却频繁遇到困难?
人可以凭直觉消除歧义、询问同事并操作图形界面。Agent 更依赖目录服务和语义层提供的结构化契约。
- 人可以理解模糊报错;Agent 需要错误码和修复建议。
- 人可以阅读叙述性文档;Agent 需要结构化接口规范。
- 人可以临时绕行;Agent 需要有文档记录的恢复路径。
高可用并不等同于 Agent-ready。可观测性不足、接口不一致和人工恢复步骤,都会影响 Agent 的任务完成能力。
应该新建 Agent 专用工具,还是改造现有工具?
优先让现有工具对 Agent 友好。许多系统已经具备所需能力,只是暴露方式不理想:
- 增加结构化错误响应。
- 提供 Dry-run/Explain 模式。
- 为数据、指标、配置等关键状态管理版本。
- 记录常见故障的恢复路径。
- 提供机器可读日志与血缘;可从语义层和 BI 工具开始。
只有在现有系统存在根本架构缺口,例如完全不支持版本机制时,才考虑构建专用工具。
系统应该有多少 Skills?
质量比数量更重要。设计良好的系统通常具有:
- 3–10 个核心 Skills,覆盖多数常见任务。
- 清楚的使用边界。
- 可组合的基础能力。
- 较低的发现成本。
五个清晰、经过测试的 Skills,通常比五百个造成上下文过载的 Skills 更有价值。相关实例见 Data Agents 资源。
版本管理与备份有什么区别?
备份用于灾难恢复,版本管理用于安全迭代。
备份解决“恢复昨天的全部状态”;版本管理解决“比较指标 v1 与 v2,只回滚指标定义,保留新的流水线代码”。
Agent-ready 系统需要数据、代码、指标、环境和 Skills 的细粒度版本,而不仅是全系统快照。Apache Iceberg 等湖表格式的分支与标签提供了这类基础能力。
小团队能建设 Agent-ready 系统吗?
可以,而且小团队有时更容易从零建立一致约定:
- 使用 Git 管理版本。
- 使用开源工具记录结构化日志。
- 优先设计 CLI 接口。
- 用 Markdown 维护轻量 Skill 文档。
- 用 JSON 日志保存可检查的执行轨迹。
大型组织往往面临历史系统、部门孤岛和复杂审批;小团队可以从第一天按 Agent-ready 原则设计。
从聊天界面封装走向 Agent 运行环境
聊天界面封装通常只是在现有工具上增加对话入口,产生答案而非持久成果,并需要持续人工照看。
Agent 运行环境则提供统一控制接口,生成可版本化的生产成果,在人的方向引导下自主执行,并将 Agent 视为一等操作者。
关键结论
- Agent-readiness 取决于控制、学习、恢复和改进能力,而非功能数量。
- CLI/MCP 是基础,任务结果才是检验标准。
- 可复用、经过测试的 Skills 会积累价值。
- 数据、代码、指标、环境与 Skills 都需要版本管理。
- 稳定性比极致性能更能建立信任。
- 人应提供方向,而非持续救场;可将每任务少于两次人工介入作为评估目标。
下一步怎么做?
评估当前系统:先让 Agent 完成五项代表性工作流,记录人工介入、完成率和调试时间,再检查版本覆盖、Skill 复用率和成本趋势。
改进系统:增加结构化报错,为高风险操作加入 Dry-run,先对指标和数据管理版本,为最常见的十种失败记录恢复路径,并将重复任务沉淀为 Skills。
来源
本文基于社区研究讨论形成的 Agentic Data Stack 评估框架,重点关注从接入能力向任务结果的转变。原讨论链接保留在英文原文中。